26 اکتبر 2023- در مطالعهای که اخیراً در مجله npj Digital Medicine منتشر شده است، محققان یک بررسی دامنهای برای تجزیه و تحلیل مدلهای مبتنی بر هوش مصنوعی (AI) برای پیشبینی دیابت نوع 2 (T2DM) انجام دادند.
اهمیت روزافزون هوش مصنوعی در مراقبت های بهداشتی
هوش مصنوعی به توسعه ی مدلهای پیشبینی دیابت کمک میکند، وضعیتی که شیوع آن در سراسر جهان رو به افزایش است. بر اساس پروفایل های خطر، این تکنیک سعی می کند خطر ابتلا به دیابت نوع 2و عوارض مرتبط با آن را ارزیابی کند. هوش مصنوعی امکان شناسایی بیماران پرخطر و توسعه روش های پیشگیرانه فردی و درمان های متمرکز را فراهم می کند.
مراحل کلیدی در توسعه ی مدل های هوش مصنوعی
مدلهای هوش مصنوعی باید در طی مراحلی ایجاد شوند از جمله ایجاد مدل، ارزیابی و ترجمه به یک پشتیبان برای تصمیمگیری بالینی. اعتبار سنجی داخلی یا خارجی می تواند مورد استفاده قرار گیرد و اعتبار سنجی خارجی برای بررسی کامل تر تعمیم پذیری مدل توصیه می شود. مدلهای مبتنی بر هوش مصنوعی بهعنوان یک رویکرد مناسب برای تولید مدلهای پیشبینی برایT2DM پدید آمدهاند، که امکان استراتژیهای پیشگیری از بیماری را فراهم میکند.
روش مطالعه
در این بررسی جامع، محققان کاربردهای رویکردهای پیشبینی مبتنی بر هوش مصنوعی را در پیشبینی خطر دیابت بررسی کردند.
دادهها بهطور سیستماتیک از پایگاههای اطلاعاتی Scopus، PubMed، Google Scholar وIEEE-Xplore برای مطالعات طولی مرتبط با استفاده از مدلهای مبتنی بر هوش مصنوعی برای افراد انسانی که بین ۱ژانویه ۲۰۰۰تا ۱۹سپتامبر ۲۰۲۲منتشر شده بودند، جستجو گردید. علاوه بر این، رفرانس مطالعات برای شناسایی سوابق اضافی، غربالگری شدند.
فقط مطالعات بررسی شده، تحقیقات اصلی، و مقالات کنفرانس با استفاده از اطلاعات پزشکی، از جمله پرونده الکترونیک سلامت(EHRs)، تصویربرداری، و مولتی اومیکس، در این مرور گنجانده شدند. این تیم مرورها، تفسیرها، سرمقاله ها، نامه ها، پیش چاپ ها، مطالعات مقطعی، مواردی که از هوش مصنوعی استفاده نمی کردند، مواردی که در مورد افراد غیرانسانی انجام شده بودند، مواردی از جمله دیابت نوع 1 و دیابت حاملگی، و کسانی که شامل افراد مبتلا به عوارض مرتبط با دیابت بودند را حذف کردند.
دادههای استخراجشده شامل عناوین، سال انتشار، نام نویسنده اول، نوع انتشار، کشور، هدف مطالعه، جامعه نمونه، طرح مطالعه، جمعیتشناسی شرکتکنندگان، روشهای مورد استفاده برای تعیین تشخیصT2DM، دوره پیگیری و نوع منبع داده بود. علاوه بر این، محققان تعداد و نوع روشهای مورد استفاده، نوع هوش مصنوعی، الگوریتمهای خاص و رویکرد اعتبارسنجی را ثبت کردند. یک مرور کننده جستجوی دادهها را انجام داد و دو فرد دیگر بطور مستقل مطالعه ها را انتخاب کرده و دادهها را استخراج نمودند و مغایرتها با بحث یا مشورت با بازبین سوم برطرف شد. برای تحلیل از رویکرد سنتز روایت(narrative synthesis) استفاده شد.
آنچه داده ها نشان دادند
در ابتدا، 1105 مورد شناسایی شد که از این تعداد 853 مورد غربالگری عنوان و چکیده، 64 مورد غربالگری متن کامل و 40 مورد برای تجزیه و تحلیل نهایی در نظر گرفته شد. بیشتر مطالعات در چهار سال گذشته منتشر شده بودند. حجم نمونه از 244 تا 1893901 نفر با جمعیت های متنوع از جمله چین، فنلاند، کالیفرنیا، و کویت متغیر بود.
رایج ترین انواع داده ها و الگوریتم ها
اکثر مطالعات از نوع همگروهی گذشته نگر بودند که دادهها را از مجموعه دادههای خصوصی بزرگ و پایگاههای اطلاعاتی در دسترس عموم مانند شبکه مراقبت مراقبت اولیه کانادا (CPCSSN)، مطالعه قلب سن آنتونیو(SAHS) و مطالعه لیپید و گلوکز تهران(TLGS) تجزیه و تحلیل کرده بودند. سطح گلوکز خون ناشتا 126 میلی گرم در دسی لیتر یا بالاتر و هموگلوبین گلیکوزیله(HbA1c) 6.5 درصد و بالاتر، رایج ترین معیارهای مورد استفاده برای تشخیصT2D بودند.
اکثر مطالعات از مدلهای هوش مصنوعی یکوجهی(n=30) استفاده کرده بودند و تنها 10 مطالعه از روشهای چندوجهی استفاده کرده بودند. در حالی که مدلهای تک وجهی سطح زیر منحنی(AUC) را 0.8 نشان دادند، مدلهای چندوجهی برتر بودند(AUC= 0.9).مدلهای یادگیری ماشینی کلاسیک(ML) در بیشترمطالعات(10 مطالعه)، باEHR (شامل دادههای جمعیتشناختی، سابقه خانوادگی دیابت، عوامل سبک زندگی، اندازهگیریهای آنتروپومتریک، صفات گلایسمی، چربی سرم، کلسترول و سطوح TG)بهعنوان متداول ترین روش داده، استفاده شده بود.
علاوه بر این، مولتی اومیکس مانند پلی مورفیسم های تک نوکلئوتیدی(SNPs)، اندازه گیری های متابولومیک، و داده های میکروبیوتاغالب بودند، در حالی که از تصویربرداری پزشکی کمترین استفاده شده بود. مدلهای یادگیری ماشینی کلاسیک از درختهای تصمیم(DT) با تغییراتشان مانند درختهای آماری سریع، بیطرفانه و کارآمد(QUEST) و درختهای طبقهبندی و رگرسیون(CART) استفاده کرده بودند. مدلسازی رگرسیون خطی، طبقهبندیکنندههای جنگل تصادفی (RF)، ماشینهای بردار پشتیبان (SVM)، طبقهبندیکنندههای خلیج ساده (NB)، تقویت گرادیان شدید (XGBoost)، وKNN به ترتیب در 10، 9 ، 8، 5، 4 و 4 مطالعه استفاده شده بودند.
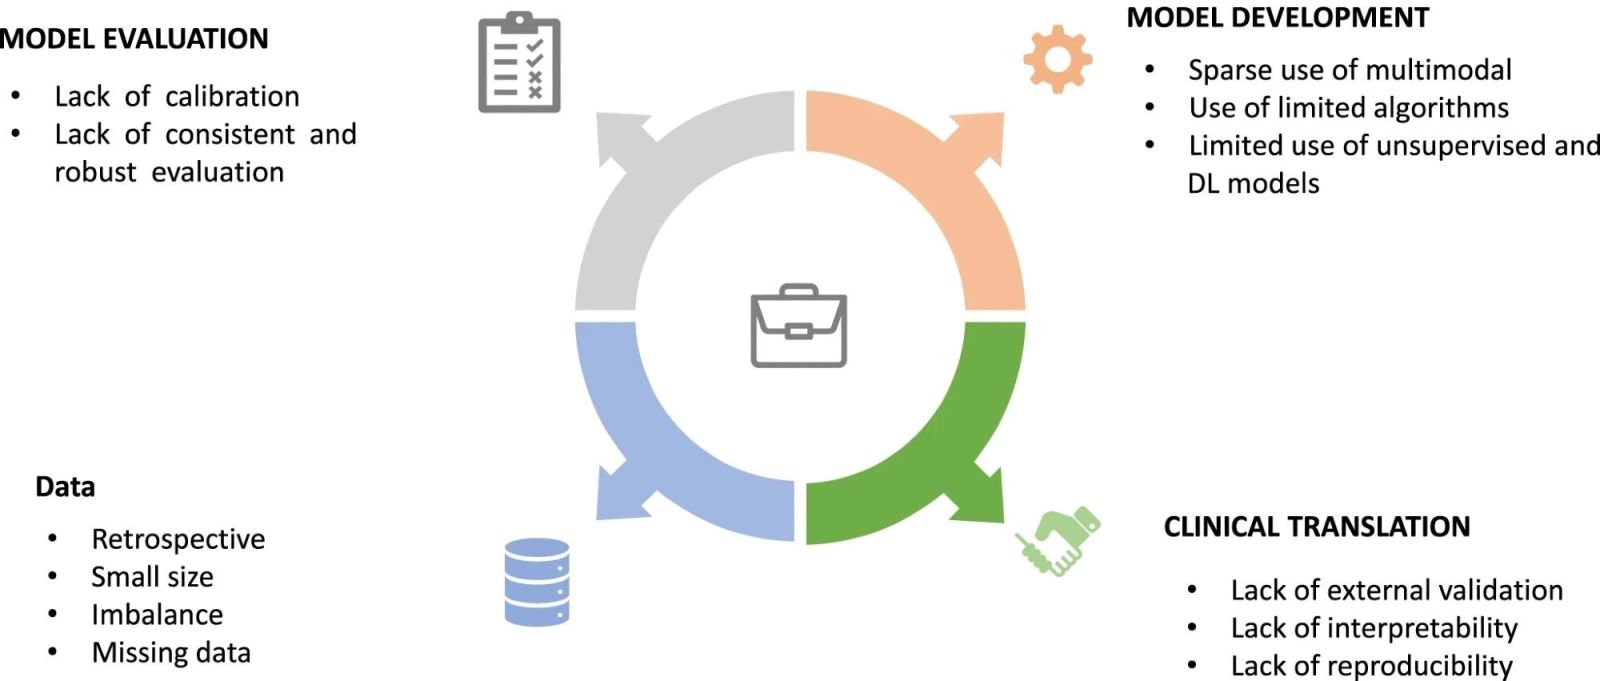
محدودیتهایی که در مراحل مختلف ساخت مدل پیشبینی هوش مصنوعی برایT2DM با آن مواجه میشویم شامل محدودیت های مرتبط با زمینه داده ها، ساخت و ارزیابی مدل، و ترجمه بالینی است.
اعتبار سنجی و تفسیرپذیری: یک جنبه انتقادی
سی و نه مطالعه اعتبار سنجی داخلی را انجام دادند، در حالی که تنها پنج مطالعه اعتبار سنجی خارجی را انجام دادند. اکثر مطالعات از مقادیر مساحت زیر منحنی (AUC) برای معیارهای تفاوت استفاده کردند. نکته قابل توجه این است که تنها پنج مطالعه کالیبراسیون مدل را ارائه کردند. 50 درصد از مطالعات از روشهای تفسیرپذیری برای شناسایی پیشبینیکنندههای ریسک استفاده کردند، و بیشتر مدلها مدلهای شناختهشده را گزارش کردند. قند خون ناشتا، شاخص توده بدنی (BMI)، سن، و تری گلیسیرید سرم (TG) شایع ترین پیش بینی کننده های خطر T2Dبودند. نشانگرهای متابولیک شامل: آلفا توکوفرول، مانوز، گلوکز، مسترانول، ایبوفلاوین، هیدروکسی فینگومیلین C14:1و فسفاتیدیل کولین آسیل آلکیل C40:5بودند. نشانگرهای زیستی مبتنی بر تصویربرداری برای بیماری شبکیه مرتبط با دیابت شامل پیچ خوردگی عروق، خونریزی شبکیه، لکههای سفید کرکی روی شبکیه یاcotton wool spotsو اتساع وریدی بود.
جهت گیری ها و چالش های آینده
بر اساس این یافتهها، مدلهای هوش مصنوعی در پیشبینی ابتلا به دیابت نوع 2 امیدوارکننده بودند، اما قبل از تحقق کامل پتانسیل آنها باید بر موانع غلبه کرد. برای ارزیابی مزایای بالقوه ی مدلهای هوش مصنوعی، اعتبارسنجی و ارزیابی گسترده از طریق آزمایشهای بالینی و تحقیقات آیندهنگر مورد نیاز است. عملکرد هوش مصنوعی در پزشکی مستقل نیست، بلکه تلاشی مشترک بین مدلهای هوش مصنوعی و دانش انسانی است.
مراحل بعدی
با وجود محدودیتها و موانع، محققان باید از فناوریهای هوش مصنوعی برای سرعت بخشیدن به کشف پیشرفتها و ترجمه آنها به عمل بالینی برای بیماران و متخصصان مراقبتهای بهداشتی استفاده کنند.
منبع:
https://www.news-medical.net/news/20231026/AI-shows-promise-in-predicting-type-2-diabetes-but-faces-hurdles-for-clinical-use.aspx